



PDF in bearbeitbaren Text umwandeln
Wandeln Sie PDFs in bearbeitbaren Text um, um die Dokumentenbearbeitung zu erleichtern. Nutzen Sie pdfFiller in Microsoft Edge für eine effiziente Lösung.
Was ist OCR und wie funktioniert es?
Optische Zeichenerkennung (OCR) ist eine Technologie, die gescannte Dokumente in bearbeitbaren Text umwandelt. Mit der OCR-Funktion von pdfFiller können Sie gescannte PDFs in bearbeitbare Formate konvertieren. Der Hauptunterschied zwischen gescannten und nativen PDFs liegt darin, dass gescannte PDFs aus Bildern bestehen, während native PDFs Textdaten enthalten. Um die DSGVO-Konformität zu gewährleisten, verarbeitet pdfFiller Ihre Daten sicher und vertraulich.
Warum gescannte PDFs nicht bearbeitet werden können
Gesannte PDFs können ohne OCR nicht bearbeitet oder extrahiert werden, da sie als Bilder gespeichert sind. Dies bedeutet, dass der Text nicht auswählbar oder bearbeitbar ist. Wenn Sie versuchen, ein gescanntes PDF ohne OCR zu bearbeiten, werden Sie feststellen, dass die Effizienz bei der Dokumentenbearbeitung stark beeinträchtigt wird. Beispielsweise können Buchhalter und Rechtsanwälte auf Schwierigkeiten stoßen, wenn sie gescannte Rechnungen oder Verträge bearbeiten möchten.
Wo finde ich die OCR-Tools in pdfFiller?
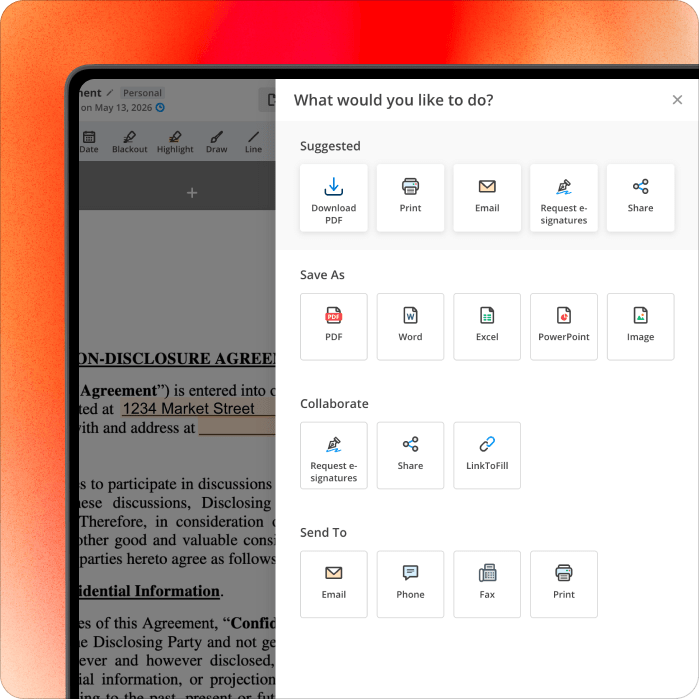
In pdfFiller finden Sie die OCR-Tools in der Benutzeroberfläche. Um OCR anzuwenden, laden Sie Ihr Dokument hoch und klicken Sie auf die OCR-Schaltfläche in der Symbolleiste. Diese Schaltfläche ermöglicht es Ihnen, die Sprache auszuwählen und den OCR-Prozess zu starten. Alternativ können Sie das OCR-Tool auch über das Alle Tools-Panel erreichen, ohne ein Dokument öffnen zu müssen.
Dokumente in pdfFiller hochladen
Um Dokumente in pdfFiller hochzuladen, können Sie verschiedene Dateiformate verwenden, einschließlich JPG und PNG. Der Upload-Prozess ist einfach: Klicken Sie auf die Schaltfläche „Hochladen“ und wählen Sie die gewünschten Dateien aus. Achten Sie darauf, dass die Qualität der hochgeladenen Bilder hoch genug ist, um optimale Ergebnisse bei der OCR-Anwendung zu erzielen.
Schritt-für-Schritt-Anleitung zur OCR-Anwendung
- Laden Sie Ihr gescanntes PDF-Dokument in pdfFiller hoch.
- Klicken Sie auf die OCR-Schaltfläche in der Symbolleiste.
- Wählen Sie die gewünschte Sprache für die Texterkennung aus.
- Starten Sie den OCR-Prozess, um das gescannte PDF in bearbeitbaren Text umzuwandeln.
- Wechseln Sie in den Bearbeitungsmodus, um Änderungen am Dokument vorzunehmen.
- Speichern Sie das bearbeitete Dokument in einem gewünschten Format, z. B. Word oder Excel.
- Teilen Sie das bearbeitete Dokument mit anderen, falls erforderlich.
Wie funktioniert die OCR-Engine von pdfFiller?
Die OCR-Engine von pdfFiller ermöglicht es Ihnen, gescannte PDFs in bearbeitbaren Text umzuwandeln. Sie unterstützt mehrere Sprachen und sorgt für eine hohe Genauigkeit bei der Texterkennung. Die Ausgabeformate umfassen bearbeitbare Dokumente wie Word und Excel. Technische Details zur OCR-Engine gewährleisten, dass die erkannten Texte in eine auswählbare Ebene umgewandelt werden, was die Bearbeitung erleichtert.
Gescanntes PDF nach OCR bearbeiten
- Wenden Sie OCR auf Ihr gescanntes PDF an.
- Wechseln Sie in den Bearbeitungsmodus, um Änderungen vorzunehmen.
- Fügen Sie Text hinzu oder ändern Sie bestehende Inhalte nach Bedarf.
- Speichern Sie die Änderungen, um die bearbeitete Version zu sichern.
Bilder in PDFs scannen
Um Bilder in PDFs zu scannen, laden Sie eine Bilddatei (JPG oder PNG) in pdfFiller hoch. Der Prozess zur Konvertierung in ein PDF ist einfach, jedoch wird keine automatische OCR angewendet. Achten Sie darauf, die Bildqualität zu überprüfen, um optimale Ergebnisse zu erzielen.
Gescanntes PDF in Word konvertieren
- Laden Sie das gescannte PDF in pdfFiller hoch.
- Wenden Sie OCR an, um den Text erkennbar zu machen.
- Wählen Sie die Option zur Konvertierung in Word aus.
- Speichern Sie das konvertierte Dokument auf Ihrem Gerät.
Text aus gescannten Dokumenten extrahieren
Um Text aus gescannten Dokumenten zu extrahieren, verwenden Sie die OCR-Funktion von pdfFiller. Nach der Anwendung von OCR können Sie den erkannten Text kopieren und in andere Dokumente einfügen. Diese Funktion ist besonders nützlich für Buchhalter, die Informationen aus gescannten Rechnungen benötigen.
Bereinigen und Schärfen gescannter PDFs
Die Bereinigung und Schärfung gescannter PDFs verbessert die visuelle Qualität des Dokuments. Bereinigungsfilter entfernen unerwünschte Elemente, während die Schärfeneinstellung die Klarheit des Textes erhöht. Diese Schritte sind wichtig, um sicherzustellen, dass der Text nach der OCR-Anwendung gut lesbar ist.
OCR für Nicht-PDF-Formate
pdfFiller ermöglicht die Anwendung von OCR auf verschiedene Nicht-PDF-Formate, einschließlich Word, Excel und PNG. Um OCR auf diese Formate anzuwenden, laden Sie die Datei in pdfFiller hoch und folgen Sie dem gleichen Prozess wie bei gescannten PDFs. Dies erweitert die Möglichkeiten zur Dokumentenbearbeitung erheblich.
Unterschied zwischen gescannten und nativen PDFs
Der technische Unterschied zwischen gescannten und nativen PDFs besteht darin, dass gescannte PDFs aus Bildern bestehen, während native PDFs Textdaten enthalten. Dies hat Auswirkungen auf die Bearbeitbarkeit und die Effizienz bei der Dokumentenverarbeitung. Bei der Arbeit mit gescannten PDFs ist die Anwendung von OCR unerlässlich, um den Text in ein bearbeitbares Format zu konvertieren.
Nächste Schritte zur Optimierung Ihres Workflows
Um Ihre Dokumentenbearbeitung zu optimieren, verwenden Sie den Workflow: Scannen → OCR anwenden → Bearbeiten → Ausfüllen → Unterzeichnen → Teilen. Mit pdfFiller können Sie diesen Prozess effizient gestalten und sicherstellen, dass Ihre Dokumente DSGVO-konform verarbeitet werden.