



Convertir PDF en Texte OCR dans Microsoft Edge
Convertissez un PDF scanné en texte éditable avec l'OCR dans Microsoft Edge.
Qu'est-ce que l'OCR et comment fonctionne-t-il ?
La reconnaissance optique de caractères (OCR) est une technologie qui permet de convertir des documents scannés ou des images de texte en texte éditable. Cette technologie est essentielle pour les petites et moyennes entreprises (PME) qui souhaitent transformer des PDF scannés en formats exploitables. Les PDF natifs contiennent du texte sélectionnable, tandis que les PDF scannés sont des images qui nécessitent l'OCR pour extraire le texte. Dans Microsoft Edge, l'utilisation de l'OCR permet d'améliorer l'efficacité et la clarté des documents, facilitant ainsi leur gestion.
Pourquoi les PDF scannés nécessitent-ils l'OCR ?
Les PDF scannés présentent des limitations significatives. Ils ne peuvent pas être modifiés directement, et l'extraction de texte est impossible sans l'application de l'OCR. Pour les PME, cela signifie que les documents importants, tels que les contrats ou les factures, ne peuvent pas être facilement manipulés. L'OCR est donc crucial pour surmonter ces défis et permettre une gestion efficace des documents numériques.
Comment accéder aux outils OCR dans pdfFiller ?
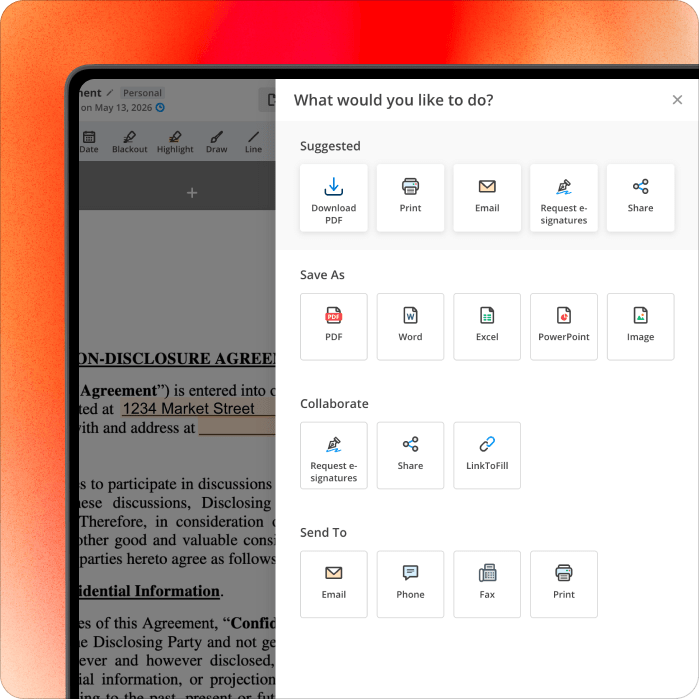
Pour accéder aux outils OCR dans pdfFiller, commencez par télécharger votre document scanné. Ensuite, localisez le bouton OCR dans la barre d'outils. Vous aurez la possibilité de sélectionner la langue de reconnaissance, ce qui est essentiel pour garantir la précision. De plus, les outils de nettoyage et d'aiguisement sont facilement accessibles dans l'interface utilisateur de pdfFiller, qui est compatible avec Microsoft Edge, offrant ainsi une expérience utilisateur fluide.
Étapes pour convertir un PDF scanné en texte
- Téléchargez le PDF scanné dans pdfFiller.
- Appliquez l'OCR en sélectionnant le bouton approprié dans la barre d'outils.
- Éditez le texte reconnu pour corriger d'éventuelles erreurs.
- Exportez le document dans le format souhaité, tel que Word ou PDF.
Comment fonctionne l'OCR dans pdfFiller ?
L'OCR dans pdfFiller fonctionne en analysant les images de texte et en les convertissant en texte sélectionnable. Le mécanisme de reconnaissance repose sur des algorithmes avancés qui identifient les caractères. La précision de l'OCR dépend de la qualité du document scanné et de la langue sélectionnée. Une fois le texte reconnu, il devient éditable, ce qui permet aux utilisateurs de modifier facilement leurs documents.
Édition d'un PDF scanné après l'OCR
- Appliquez l'OCR sur le PDF scanné pour convertir l'image en texte.
- Accédez au mode édition pour commencer à modifier le texte reconnu.
- Effectuez les modifications nécessaires pour corriger le contenu.
- Enregistrez les modifications apportées au document.
Scanner des images en PDF
Pour scanner des images en PDF, téléchargez un fichier image au format JPG ou PNG dans pdfFiller. Le processus de conversion est simple et ne nécessite pas l'application automatique de l'OCR. Il est important de s'assurer que la qualité de l'image est suffisante pour garantir une conversion réussie en PDF.
Conversion de PDF scannés en Word
La conversion de PDF scannés en formats éditables, comme Word, nécessite l'application de l'OCR suivie de la conversion de format. Les utilisateurs peuvent facilement extraire le texte d'un document scanné et le transformer en un fichier Word, ce qui est particulièrement utile pour les PME qui ont besoin d'éditer des documents rapidement.
Extraction de texte à partir de documents scannés
pdfFiller propose des outils d'extraction qui permettent aux utilisateurs de récupérer le texte reconnu à partir de documents scannés. Pour extraire en masse, sélectionnez le modèle approprié, puis utilisez l'outil d'extraction pour télécharger les données sous forme de feuille de calcul. Cela facilite la gestion des informations contenues dans des documents scannés.
Nettoyer et aiguiser les PDF scannés
Les options de nettoyage dans pdfFiller permettent d'améliorer la qualité des PDF scannés. Les filtres de nettoyage peuvent effacer les bordures noires et redresser automatiquement les images. L'option d'aiguisement améliore la clarté visuelle, ce qui est essentiel pour garantir que l'OCR fonctionne efficacement et que le texte soit correctement reconnu.
Limitations de l'OCR dans pdfFiller
Bien que l'OCR dans pdfFiller soit puissant, il existe certaines limitations. Le support linguistique peut varier, et la précision peut diminuer avec des scans de faible résolution ou des documents manuscrits. De plus, il y a une taille de fichier maximale pour le traitement OCR, et certaines fonctionnalités, comme l'extraction de texte, peuvent nécessiter un abonnement payant.
Comparaison avec d'autres outils OCR
pdfFiller se distingue des autres outils OCR tels qu'Adobe Acrobat, Smallpdf et ABBYY FineReader. Adobe Acrobat offre des fonctionnalités avancées, mais à un coût élevé, ce qui le rend moins accessible pour les PME. Smallpdf est simple à utiliser, mais manque de certaines fonctionnalités avancées. ABBYY FineReader est reconnu pour sa précision, mais peut être trop complexe pour les utilisateurs non spécialisés.
Prochaines étapes après l'OCR
Après avoir appliqué l'OCR, il est essentiel de connecter ce processus à un flux de travail plus large. Cela inclut le scan, l'application de l'OCR, l'édition, le remplissage, la signature et le partage des documents. Cette intégration permet aux PME de gérer efficacement leurs documents numériques et d'améliorer leur productivité.