









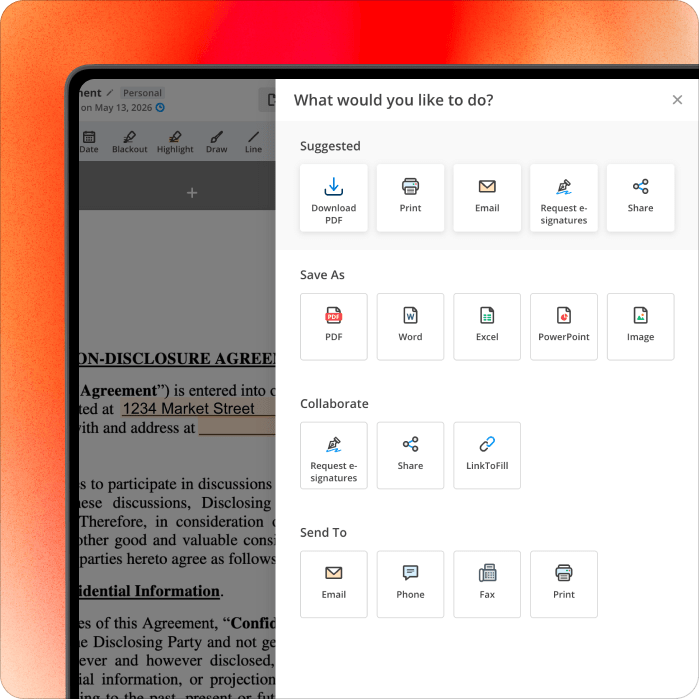


Reconnaître le texte dans un PDF
Reconnaître le texte dans un PDF scanné avec pdfFiller pour faciliter l'édition et l'extraction.
Qu'est-ce que l'OCR et comment fonctionne-t-il ?
L'OCR, ou reconnaissance optique de caractères, est une technologie permettant de convertir des documents scannés en texte modifiable. Contrairement aux PDF natifs, qui contiennent des informations textuelles directement accessibles, les PDF scannés sont des images de documents. Cela rend l'édition et l'extraction d'informations difficile sans utiliser l'OCR. Pour les PME, cette technologie est essentielle pour gérer efficacement les documents, car elle permet de transformer des fichiers scannés en formats exploitables.
Pourquoi les PDF scannés nécessitent-ils l'OCR ?
Les PDF scannés, sans OCR, ne peuvent pas être édités. Cela limite la capacité des PME à modifier des contrats, des factures ou d'autres documents importants. Par exemple, un contrat scanné ne pourra pas être mis à jour sans passer par un processus de reconnaissance de texte. L'absence d'OCR peut également nuire à l'efficacité des PME, car elles perdent du temps à rechercher des informations dans des documents non modifiables.
Comment accéder aux outils OCR dans pdfFiller ?
- Ouvrez pdfFiller dans votre navigateur web.
- Accédez à l'onglet "Outils" dans le menu principal.
- Sélectionnez l'option "OCR" pour activer la reconnaissance de texte.
- Choisissez la langue souhaitée pour l'OCR dans les paramètres.
- Vous pouvez accéder à ces outils sans avoir besoin d'ouvrir un document au préalable.
Étapes pour reconnaître le texte dans un PDF
- Importez le fichier PDF scanné dans pdfFiller.
- Activez l'outil OCR en sélectionnant l'option appropriée.
- Choisissez la langue du texte à reconnaître pour une meilleure précision.
- Attendez que le processus d'OCR soit terminé, ce qui peut prendre quelques minutes.
- Une fois le texte reconnu, vous pouvez l'éditer directement dans pdfFiller.
- Pour convertir le document en Word, utilisez l'option d'exportation disponible.
Comment éditer un PDF scanné après l'OCR ?
Après avoir reconnu le texte dans un PDF, le processus d'édition se déroule en deux étapes. D'abord, activez le mode d'édition dans pdfFiller. Ensuite, apportez les modifications nécessaires au texte reconnu. Par exemple, vous pouvez corriger des erreurs ou ajouter des informations. Cette méthode permet de transformer un document scanné en un fichier modifiable, facilitant ainsi la gestion des documents pour les PME.
Comment convertir un PDF scanné en Word ?
Pour convertir un PDF scanné en document Word, commencez par appliquer l'OCR sur le fichier. Une fois le texte reconnu, utilisez l'option d'exportation pour choisir le format Word. Notez que certaines mises en page peuvent ne pas être parfaitement reproduites. pdfFiller facilite cette conversion, mais il est important de vérifier le document final pour toute incohérence.
Extraction de texte à partir de documents scannés
Pour extraire du texte de documents scannés, utilisez l'outil d'extraction disponible dans pdfFiller. Sélectionnez le document, puis choisissez l'option d'extraction. Vous aurez la possibilité de télécharger le texte extrait dans différents formats. Par exemple, vous pouvez l'enregistrer en tant que fichier texte ou l'intégrer directement dans un document Word. Cette fonctionnalité est particulièrement utile pour les PME qui ont besoin de récupérer rapidement des informations à partir de documents scannés.
Comment nettoyer et améliorer la qualité des PDF scannés ?
Pour améliorer la qualité des PDF scannés, pdfFiller propose plusieurs outils de nettoyage. Vous pouvez appliquer des filtres pour réduire le bruit et améliorer la lisibilité. De plus, des options d'amélioration de la qualité permettent d'optimiser le contraste et la clarté. Ces améliorations peuvent avoir un impact significatif sur l'efficacité de l'OCR, car un document de meilleure qualité sera plus facilement analysé.
Comparaison avec d'autres outils OCR
pdfFiller se distingue des autres solutions OCR par sa facilité d'utilisation et son intégration de gestion de documents. Par exemple, Adobe Acrobat offre des fonctionnalités avancées, mais à un coût plus élevé. Smallpdf, bien qu'efficace, est plus limité en termes de traitement de texte. ABBYY FineReader peut fournir une précision supérieure, mais nécessite souvent une configuration IT, ce qui n'est pas le cas avec pdfFiller.
Prochaines étapes après avoir reconnu le texte
Après avoir reconnu le texte dans un PDF, il est crucial de l'intégrer dans un flux de travail plus large. Cela peut inclure l'édition, l'archivage ou le partage du document avec d'autres outils de gestion. Par exemple, une PME pourrait utiliser le texte reconnu pour mettre à jour des bases de données ou générer des rapports. L'intégration de l'OCR avec d'autres outils améliore l'efficacité globale et assure la conformité avec les exigences de gestion de documents.